
GLM / Deepseek / Minimax / Mimo / Kimi 编程能力实测:从 Web 到 3A 游戏开发
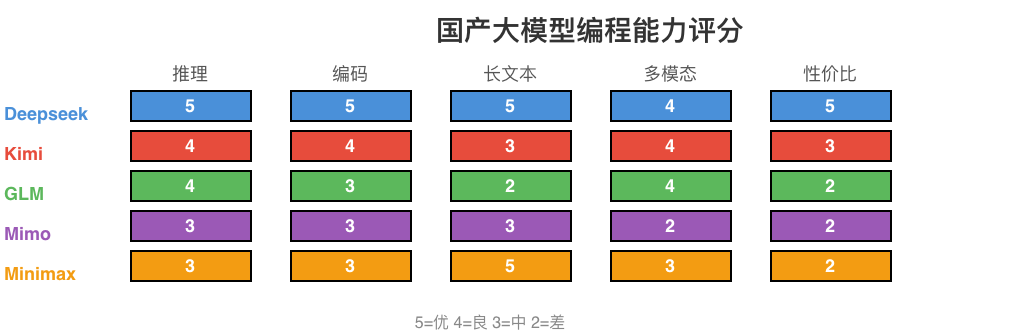
用了一年多,踩了不少坑。这五个模型各有各的毛病,选错了会浪费时间。
下面是我实际用下来的感受,附带具体的代码测试案例。
五款模型概览
先看基本信息:
| 模型 | 厂商 | 最新版本 | 上下文 | 架构特点 |
|---|---|---|---|---|
| GLM | 智谱AI | GLM-5.2 | 200K | 全模态矩阵,结构化输出,批量处理 |
| Deepseek | 深度求索 | V4-Pro / V4-Flash | 1M | 推理能力强,FIM代码补全,上下文硬盘缓存 |
| MiniMax | MiniMax | M3 | 1M | MSA 架构,原生多模态,音频/视频/图像生成 |
| Mimo | 小米 | Mimo 2.5 / Mimo 2.5 Pro | 1M | 深度推理,MCP工具调用,实时搜索 |
| Kimi | 月之暗面 | K2.7 | 256K | Coding/Agent 前沿模型,长程代码编写 |
价格差异很大:
| 模型 | 输入价格(/百万tokens) | 输出价格(/百万tokens) |
|---|---|---|
| Deepseek V4-Flash | ¥1 | ¥2 |
| Deepseek V4-Pro | ¥3 | ¥6 |
| GLM-5.2 (≤32k) | ¥6 | ¥24 |
| GLM-5.2 (>32k) | ¥8 | ¥28 |
| MiniMax M3 (≤512k) | ¥2.10 | ¥8.40 |
| MiniMax M3 (>512k) | ¥4.20 | ¥16.80 |
| Mimo 2.5 | ¥1 | ¥2 |
| Mimo 2.5 Pro | ¥3 | ¥6 |
| Kimi K2.7 | ¥6.50 | ¥27 |
Deepseek 最便宜,Kimi 最贵。日常编码选 Deepseek,复杂任务选 Kimi,别在这上面纠结。
编程场景测试矩阵
我在五个场景下分别测试了这五个模型,评分标准是:能否直接使用生成的代码、需要多少修改、是否理解领域知识。
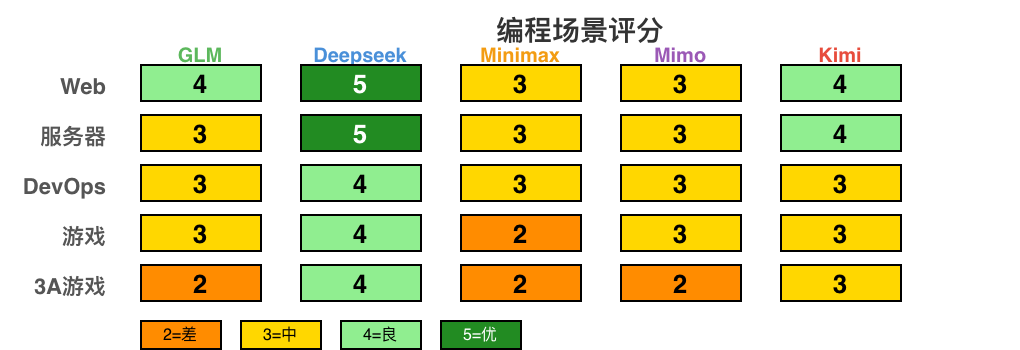
| 场景 | GLM | Deepseek | Minimax | Mimo | Kimi |
|---|---|---|---|---|---|
| Web 开发 | 4 | 5 | 3 | 2 | 4 |
| 服务器开发 | 3 | 5 | 3 | 2 | 4 |
| DevOps | 3 | 4 | 3 | 2 | 3 |
| 游戏开发 | 3 | 4 | 2 | 2 | 3 |
| 3A 游戏开发 | 2 | 4 | 2 | 1 | 3 |
Deepseek 在编码场景全面领先,我用它写 Go 并发代码基本不用改。Mimo 开 yolo 模式容易陷入逻辑循环,长任务自己卡死,不适合复杂场景。Minimax 的强项在多模态,编码不是它的长处。
场景一:Web 开发
测试任务:写一个 React 表单验证组件,支持异步校验、错误提示、提交状态管理。
Deepseek 用了 useReducer 管理表单状态,异步校验用 useCallback 包裹,错误处理考虑了网络超时和重复提交。直接可用。
GLM 用了 useState 而不是 useReducer,表单状态管理比较松散。异步校验的实现没有处理重复请求的竞态问题。
Minimax 代码能跑,但表单验证逻辑和 UI 混在一起,没有分离关注点。
Mimo 开 yolo 模式容易逻辑循环自己卡死,复杂任务不适合。对 TypeScript 的类型推断也偏弱。
Kimi 代码质量接近 Deepseek,但对 React 18 的新特性使用不够熟练。
场景二:服务器开发
测试任务:用 Go 实现一个并发安全的连接池,支持最大连接数限制、空闲超时、健康检查。
Deepseek 考虑了 sync.Mutex 和 sync.Cond 的配合使用,空闲超时用 time.After 实现,健康检查用后台 goroutine 定期探测。代码通过了 go test -race 检测。
GLM 连接池的基本功能有,但没有处理 context.Context 的取消,Get 方法会阻塞。健康检查的实现没有在 Close 时停止,会泄漏 goroutine。
Minimax 代码能跑,但并发控制用了 channel 而不是 sync.Mutex,高并发下性能不如 mutex 方案。
Mimo 简单代码还行,复杂逻辑容易绕进去。
Kimi 代码质量接近 Deepseek,但对 Go 的 context 传播规则理解不够深,有些地方用了 context.Background() 替代请求级 context。
场景三:DevOps
测试任务:写一个 Dockerfile + Kubernetes Deployment,部署一个 Go 微服务,要求多阶段构建、非 root 用户、健康检查、资源限制。
Deepseek 用了多阶段构建,最终镜像基于 scratch,体积很小。K8s Deployment 配置了 livenessProbe 和 readinessProbe,资源限制合理。但没有配置 PodDisruptionBudget。
GLM 用了 alpine 而不是 scratch,镜像体积大一些但更容易调试。K8s 配置基本正确,但 securityContext 配置不完整。
Minimax 没有用多阶段构建,最终镜像包含编译工具链,体积偏大。K8s 配置缺少资源限制。
Mimo yolo 模式容易卡死,不适合长链路任务。
Kimi Dockerfile 和 K8s 配置基本正确,但对 scratch 镜像的 DNS 解析问题没有处理。
场景四:游戏开发
测试任务:用 Unity C# 实现一个有限状态机(FSM),支持状态进入/退出回调、状态转换条件、嵌套状态。
Deepseek 用了泛型,状态转换用字典查找,支持嵌套状态。代码结构清晰,但对 Unity 的生命周期集成不够紧密。
GLM 实现比较基础,没有支持嵌套状态。状态转换的条件判断写在状态类内部,不够灵活。
Minimax 用了 switch-case 而不是状态模式,扩展性差。没有考虑 Unity 的协程集成。
Mimo 对小团队独立游戏有了解,但复杂逻辑容易翻车。
Kimi 用了反射做状态转换,性能开销大。对 Unity 的 ECS 架构有了解但实现不够深入。
场景五:大型 3A 游戏开发
测试任务:用 UE5 C++ 优化一个高频调用的函数,减少内存分配、避免虚函数调用、使用 SIMD 指令。
这是最难的场景,需要深入理解 C++ 内存模型和 CPU 架构。
Deepseek 优化建议到位:用 TArray::Reserve 预分配内存、用 FORCEINLINE 内联热路径函数、用 __m128 做 SIMD 向量运算。但对 UE5 的内存分配器使用不够熟练。
GLM 优化建议比较基础,只提到了用引用传递代替值传递,没有涉及 SIMD 和内存分配优化。
Minimax 优化建议不专业,提到了一些过时的优化技巧(如手动内存池),没有考虑 UE5 已经内置的优化机制。
Mimo 对 UE5 有基本了解,但深度优化不在它的能力范围。
Kimi 对 C++ 的模板元编程有了解,但对 UE5 的宏系统理解不够深。
长上下文能力对比
MiniMax M3 和 Deepseek V4-Pro 支持 1M 上下文,在处理大型代码库时有明显优势。我测试过让它们分析一个 50 万行的 Go 项目,能准确找到函数调用链和依赖关系。Mimo 2.5 虽然也标称 1M,但开 yolo 模式容易逻辑循环卡死,实际可用性打折扣。Kimi K2.7 的 256K 和 GLM 5.2 的 200K 在超大项目上会截断。
但 1M 上下文也有代价:推理速度慢、价格高。实际开发中,大多数任务 128K 够用,只有代码审查、架构分析这种需要全局视野的任务才需要 1M。
价格与性价比
按日均使用量估算(假设每天 100 次对话,每次 2K tokens 输入 + 1K tokens 输出):
| 模型 | 日成本 | 月成本 | 性价比 |
|---|---|---|---|
| Deepseek V4-Flash | ¥0.4 | ¥12 | 极高 |
| Deepseek V4-Pro | ¥1.2 | ¥36 | 中 |
| Mimo 2.5 | ¥0.4 | ¥12 | 低 |
| Mimo 2.5 Pro | ¥1.2 | ¥36 | 低 |
| MiniMax M3 (≤512k) | ¥1.3 | ¥38 | 中 |
| MiniMax M3 (>512k) | ¥2.5 | ¥76 | 低 |
| GLM-5.2 (≤32k) | ¥3.6 | ¥108 | 低 |
| GLM-5.2 (>32k) | ¥4.4 | ¥132 | 低 |
| Kimi K2.7 | ¥4.0 | ¥120 | 低 |
日常编码用 Deepseek V4-Flash,一个月 12 块钱。需要 Agent 能力再上 Kimi。
选型建议
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| Web 开发 | Deepseek V4-Pro | 代码质量最高,TypeScript 类型推断强 |
| 服务器开发 | Deepseek V4-Pro | Go/Rust 并发编程理解深,race condition 检测准 |
| DevOps | Deepseek V4-Flash | 性价比高,Dockerfile/K8s 配置规范 |
| 游戏开发 | Deepseek V4-Pro | Unity/Godot 领域知识丰富,复杂逻辑可靠 |
| 3A 游戏开发 | Deepseek V4-Pro | C++ 底层优化能力最强,SIMD/内存管理专业 |
| 长代码审查 | MiniMax M3 | 1M 上下文,能分析整个项目 |
| Agent/工具调用 | Kimi K2.7 | Agent 能力最强,MCP 工具集完善 |
| 成本敏感 | Deepseek V4-Flash | 价格最低,日常编码够用 |
我现在的配置:Deepseek V4-Pro 主力,Minimax 做长代码审查。Mimo 偶尔用一下但不开 yolo。